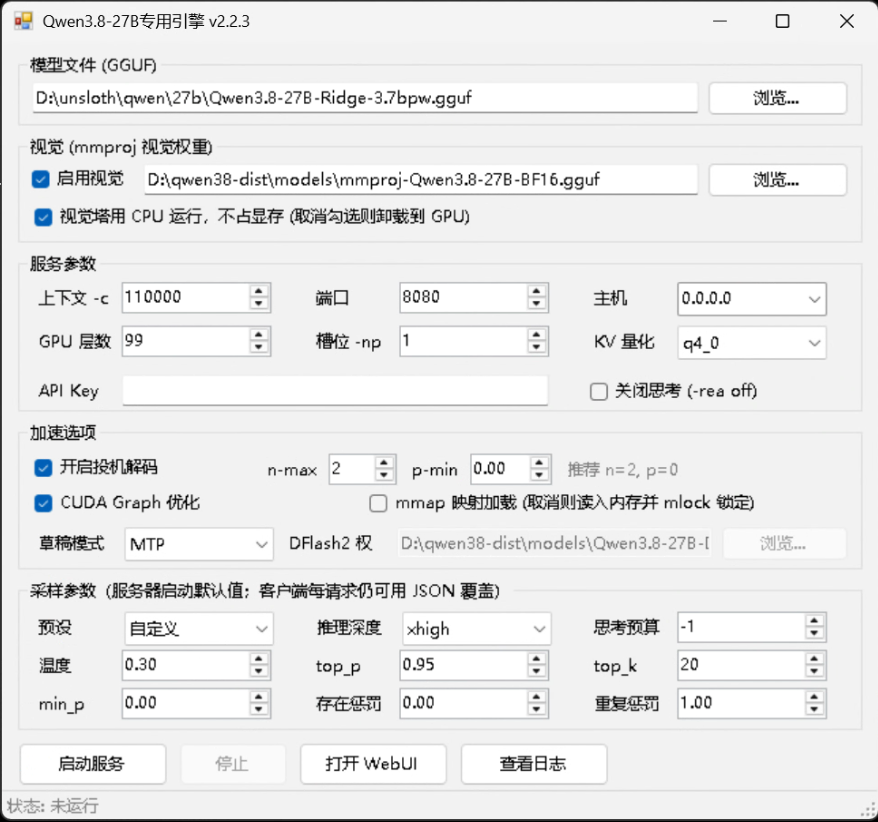
# qwen38 — 单卡 16GB 上的 27B 本地大模型推理方案
qwen38 是一套为 **Qwen3.8-27B** 深度定制的本地推理发行包。它不是通用推理框架的简单搬运,而是围绕这一个模型、一类典型硬件(16GB 消费级显卡)做的整体工程优化:从内核、投机解码算法到图形化启动器,全部针对真实日常使用场景调校。
## 核心优势
### 消费级显卡,旗舰级模型
27B 参数量的模型通常被视为"显存大户"。qwen38 通过精细的显存规划与混合量化方案,让完整模型常驻一张 16GB 消费级显卡,同时保留 5 万 token 以上的长上下文窗口——读完整份代码库、长篇文档、多轮对话历史,都不在话下。
### 快,而且稳
qwen38 内置自研的**混合投机解码流水线**:轻量草稿模块先行预测,主模型并行验证,配合 n-gram 缓存回退机制,重复性内容几乎零成本命中。在日常编程与写作负载下,生成速度稳定维持在每秒数十个 token 的可用区间——快不是瞬间峰值,而是持续输出不抖动。
底层 CUDA 内核经过逐项实测筛选:图形捕获全程开启,每一步都验证过真实收益,没有"理论上更快"的玄学开关。
### 为真实场景调校,不为跑分调校
加速策略按负载类型区分:编程开发与散文写作对草稿词表的需求完全不同,qwen38 提供一键切换,默认配置直接取自真实编程环境的实测结论,而非合成基准的纸面最优。
### 双击即用
无需命令行,无需环境配置。图形化启动器集成了全部调优成果:确认选项、点"启动服务"、打开网页界面,三步开始对话。配置自动保存,下次启动原样恢复。
### 开放兼容
内置 OpenAI 兼容 API 与网页聊天界面,可无缝接入 Continue、Cline 等 IDE 插件、Agent 框架或任何支持 OpenAI 协议的前端——本地模型,云端体验。
### 数据不出机
完全离线运行。代码、文档、对话内容不离开本机,适合对隐私与合规有要求的开发环境。
### 持续进化
内核基于 llama.cpp 上游持续同步,本地优化以补丁层形式维护、可安全 rebase;每一次上游更新都经过"是否与本模型相关"的评估,只吸收真实收益。
## 适用人群
- 希望在本地流畅运行 27B 级模型的个人开发者
- 需要代码补全 / Agent 编程后端但不愿上传代码的团队
- 对响应速度和稳定性有要求的写作、翻译、知识问答场景
## 开始使用
双击 `qwen38-launcher.exe`,详见包内《使用说明》。
## 权重下载地址:
> https://www.modelscope.cn/models/empero-ai/Qwen3.8-27B-Ridge-GGUF
> https://huggingface.co/empero-ai/Qwen3.8-27B-Ridge-GGUF
v2.3.1
2026-09-05 13:55:50
### 内核升级
### 增加显卡选择,判断显卡驱动
v2.3.0
2026-09-02 21:17:56
### 增加DFLASH2推理解码,修改GUI布局,增加mmap选项
v2.2.0
2026-08-28 22:29:37
## 增加视觉支持
### 视觉模型可以选择卸载到CPU推理,不占用显存,释放更多上下文给LLM
v2.1.0
2026-08-23 18:18:26
# Qwen3.8-27B 专用引擎 - 更新日志
## 2026-08-23
全系显卡支持、启动器改名"专用引擎"并便携化、dist 整包拷贝即用。
### 支持显卡
RTX 50 / 40 / 30 / 20 系及 GTX 16 系(sm_120/89/86/75)。GTX 10 系及更早不支持。
### 实测速度(RTX 5080 16GB,turbo3 KV,同负载受控对比)
| 场景 | 浅上下文 | 40K | 78-80K |
|---|---|---|---|
| 纯 DFlash2 decode | 64-71 t/s | ~65 t/s | **61.8 t/s(深上下文最快)** |
| MTP+ngram decode | 70-83 t/s | - | 52.8-56.2 t/s |
| 无投机 decode | 55.5 t/s | 44.3 t/s | 36.4 t/s |
| Prefill | 1780 t/s | 1274 t/s | 1014-1160 t/s |
77K 全量灌入约 64 秒。
实际使用记录(MTP+ngram):**峰值 197 t/s、最低 50 t/s**——重复内容多时 ngram
连续命中会爆发冲高,受控测试只反映持续均值,日常体感上限比表中更高。
深上下文请用纯 DFlash2 或 MTP+ngram;浅上下文三种投机模式均可。
### DFlash2 显存配置
| 显存 | 上下文上限 | decode |
|---|---|---|
| 16 GB | 100-128K | 上表实测 |
| 12 GB | ~40K | ~65 t/s(估) |
| 8/11 GB | 放不下本模型 | - |
### 大显存预测(估算)
| 显卡 | decode | 上下文上限 |
|---|---|---|
| RTX 5090 32GB | 5080 的 ~1.6-1.8x | 满血,可升 turbo4/q8_0 KV |
| RTX 4090 24GB | ≈ 5080 | ~256K |
| RTX 3090 24GB | 5080 的 ~90-95% | ~256K |
v2.0.0
2026-08-21 16:58:56
## 更新核心算法,提高推理速度最快可达136token/s,编程可达70-90token/s
v1.0.0
2026-08-21 16:57:18
## 首次发布
- 初始版本
- 包含全部基础功能